Qu'est-ce qu'une hallucination de chatbot ?
Une hallucination, c'est une réponse fausse ou non fondée, énoncée avec assurance. Le chatbot ne cherche pas à tromper : il produit la suite de mots la plus plausible, y compris quand il ne sait pas. En entreprise, le danger ne vient pas de l'erreur elle-même, mais de la confiance avec laquelle elle est affirmée : une clause de contrat inventée, un seuil faux, une procédure qui n'existe pas.
On distingue deux familles. L'hallucination intrinsèque contredit le contexte fourni au modèle. L'hallucination extrinsèque ajoute un fait absent de toutes les sources — une date, un nom, un numéro d'article. La première trahit souvent un défaut de génération ; la seconde, la plus fréquente, un défaut de recherche en amont.
Pourquoi un chatbot hallucine : la mécanique du modèle
Un grand modèle de langage (LLM) ne « sait » rien au sens humain : il prédit le prochain mot le plus probable, token après token. Sa fonction objective est la plausibilité, pas la fidélité à vos documents. Privé d'une source fiable, il comble le vide avec une formulation probable. C'est précisément cela, une hallucination.
Deux mécanismes aggravent le phénomène. Le modèle n'a pas de « je ne sais pas » par défaut : c'est une capacité qu'il faut lui demander d'exercer. Surtout, une analyse publiée par OpenAI montre que les hallucinations peuvent être mathématiquement inévitables : dès que l'incertitude est pénalisée autant que l'erreur, la stratégie optimale du modèle devient de toujours deviner. The Conversation résume cette démonstration pour un public non spécialiste.
Sans RAG, un chatbot répond avec la moyenne de ce qu'il a vu pendant son entraînement. Or, pour vos règles internes, vos versions de contrats et votre historique, cette moyenne est fausse par construction. C'est précisément pour changer ce point de départ qu'on connecte le chatbot à ses documents via le RAG.
Le RAG : un chatbot connecté à vos documents, pas à sa mémoire
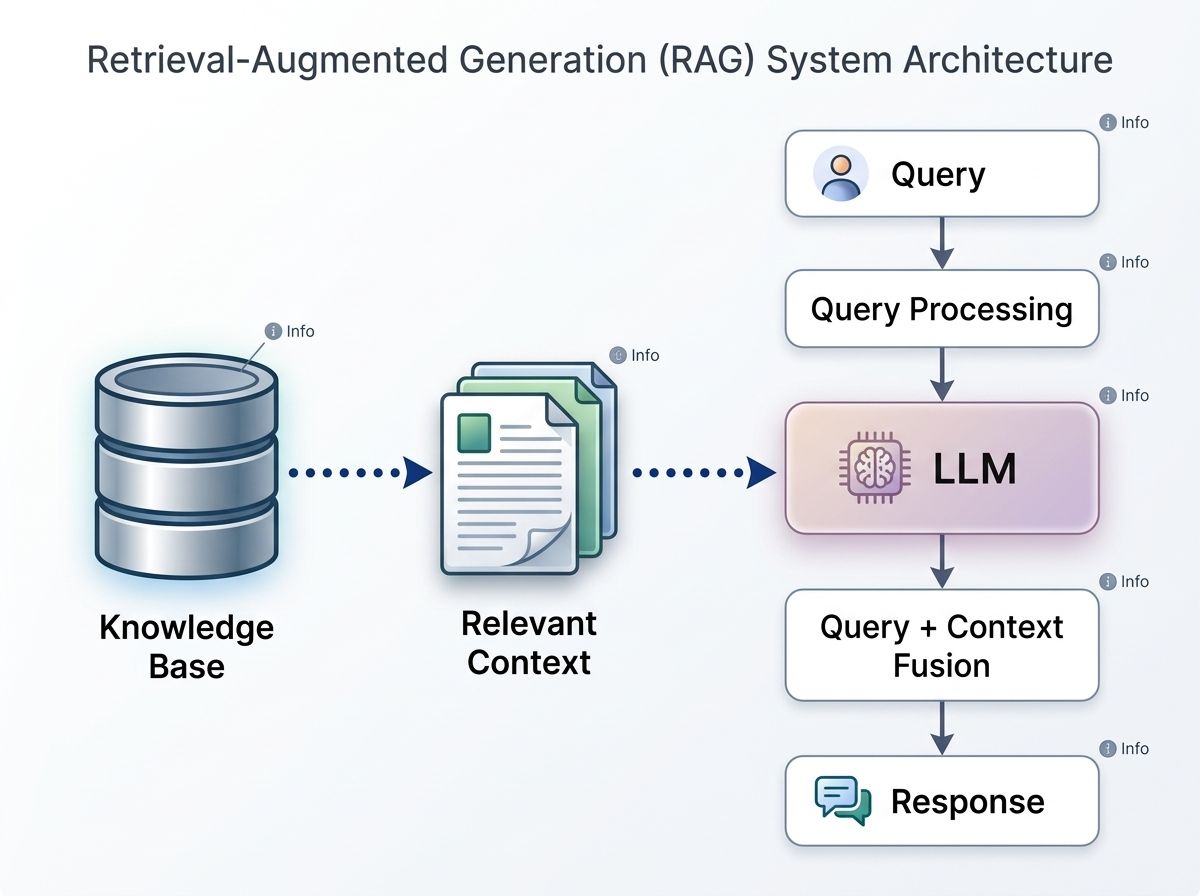
Un chatbot RAG (retrieval-augmented generation) cherche d'abord dans vos sources — PDF, procédures, contrats, fiches produit — puis rédige sa réponse à partir des passages sélectionnés. Le modèle travaille à livre ouvert : sa mémoire approximative est remplacée par un contexte précis, récupéré au moment de la question.
Le pipeline enchaîne quatre étapes : l'ingestion (les documents sont découpés et indexés), la recherche (la question devient une requête), la génération (le modèle rédige à partir des passages retenus) et le contrôle (vérification de la confiance et escalade humaine si la source manque). C'est cette architecture que nous mettons en œuvre dans nos chatbots RAG connectés aux documents internes.
Bien conçu, le RAG élimine la majorité des réponses non fondées : le modèle n'a plus besoin de deviner, il synthétise. Le piège inverse existe aussi : un mauvais RAG remplace une erreur générique par une erreur rédigée dans votre ton, parfois en citant un passage qui n'existe pas. Le RAG déplace le problème avant de le réduire — d'où les causes suivantes.
Pourquoi un chatbot RAG peut encore halluciner : deux causes, deux diagnostics
Face à une hallucination en production, la première question n'est pas « faut-il changer de modèle ? », mais : la bonne information était-elle dans le contexte fourni au modèle ? Deux réponses, deux diagnostics.
Cause 1 : la recherche n'apporte pas la bonne information
La question est ambiguë, le bon passage n'a pas été récupéré, le document n'a jamais été ingéré, ou la réponse n'existe tout simplement pas dans vos données. Le modèle répond quand même, dans le style de vos documents — c'est le cas le plus dangereux. En pratique, la majorité des hallucinations d'un chatbot RAG sont des échecs de recherche, pas des défauts du modèle.
Cause 2 : la génération déforme l'information récupérée
Le passage pertinent est bien dans le contexte, mais le modèle le paraphrase, confond deux documents ou invente un détail : un numéro, une date, un seuil. Sur les textes denses — juridique, finance, RH — c'est fréquent. La fidélité au contexte n'est pas un objectif du modèle : c'est une contrainte qu'on lui impose, et qu'il faut vérifier.
Comment éviter les hallucinations d'un chatbot RAG : les leviers qui marchent
Aucune technique ne garantit zéro hallucination. L'objectif réaliste est de les rendre rares, détectables et sourcées. Voici les leviers qui, combinés, y parviennent, dans l'ordre où ils comptent.
1. Soigner les données, d'abord
Le système vaut ce que valent vos sources. Éliminez les doublons et les versions concurrentes, indexez des documents à jour et validés, ajoutez des métadonnées (type, version, date d'effet, périmètre). Un corpus mal gouverné amplifie tous les défauts suivants.
2. Découper selon la structure, pas au kilométrage
Couper un document tous les X tokens sépare une définition de son exemple ou une clause de son contrat. On découpe selon la structure réelle — sections, tableaux, listes — et on répète titres et en-têtes dans chaque morceau pour qu'un passage reste compréhensible isolé.
3. Combiner recherche sémantique et recherche lexicale
La recherche vectorielle seule échoue sur les termes exacts — numéro de procédure, référence de clause, code produit. On combine recherche dense et recherche par mots-clés (BM25), puis un reranking ne conserve que les passages réellement utiles pour la réponse.
4. Écrire un prompt qui est un contrat
Le modèle doit recevoir des règles fermes : répondre uniquement à partir du contexte fourni, citer les passages utilisés, dire « je ne sais pas » (ou escalader vers un humain) si l'information est absente. C'est le garde-fou le plus rentable, et le plus souvent négligé.
5. Assumer les refus et les seuils de confiance
Sous un certain score de pertinence, mieux vaut refuser que répondre. Une IA qui dit « je n'ai pas cette information dans nos documents, voici où regarder » est utilisable ; une IA qui répond toujours doit être relue, donc inutile en production.
6. Citer les sources, systématiquement
Chaque affirmation doit pointer vers le passage exact qui la soutient. L'utilisateur vérifie en quelques secondes, le support identifie l'origine d'une réponse, et les dérives se détectent plus tôt. Une réponse sans source n'est pas une réponse : c'est le modèle qui parle.
7. Valider automatiquement chaque réponse
Un validateur de provenance compare phrase par phrase la réponse au contexte récupéré ; toute phrase non soutenue est supprimée ou signalée. Un second modèle (LLM-as-judge) peut noter la fidélité, comme le documente le framework RAGAS.
8. Garder un humain sur les cas critiques
Pour les domaines sensibles — RH, contrat, paiement, santé — la décision automatique n'est pas une option : réponse automatique pour les questions à faible criticité, relecture obligatoire dès qu'une obligation contractuelle est en jeu, escalade vers un expert. C'est ce niveau de maîtrise que nous intégrons dans nos agents IA autonomes.
Mesurer les hallucinations avant le lancement
Un LLM-as-judge automatise l'évaluation à grande échelle ; une relecture humaine de 10 à 20 % des cas fournit la vérité terrain. Rejouez le jeu à chaque changement de chunking, d'index, de modèle ou de prompt. C'est le moyen le plus sûr d'éviter que vos utilisateurs découvrent les hallucinations à votre place.
- la fidélité : chaque affirmation de la réponse est-elle soutenue par le contexte récupéré ?
- la pertinence du contexte : la recherche a-t-elle ramené le bon passage ?
- la pertinence de la réponse : répond-elle à la question posée ?
- le taux de refus : sur les questions sans réponse, l'IA a-t-elle refusé ou inventé ?
Conclusion : un chatbot fiable se construit, il ne se décrète pas
Les hallucinations ne sont pas une fatalité : ce sont le symptôme d'une chaîne — données, recherche, génération, contrôle — qu'on peut concevoir et surveiller. Le RAG fournit l'ancrage, le prompt et les citations apportent la traçabilité, les garde-fous et la mesure transforment l'erreur en signal d'amélioration.
C'est cette chaîne que nous déployons dans nos chatbots RAG comme dans les agents IA que nous lançons en entreprise : sources citées, mode « je ne sais pas », escalade humaine et hébergement en France ou en Europe. Si vous voulez un assistant fiable sur vos propres documents, parlons de votre projet — réponse sous 24h ouvrées, audit gratuit.
FAQ : hallucinations et chatbot RAG
Le RAG élimine-t-il complètement les hallucinations ?
Non. Il change leur profil : de réponses plausibles et génériques, on passe à des réponses sourcées et vérifiables. Une architecture sérieuse rend les erreurs rares et détectables ; rien ne garantit 0 % d'hallucination, et les équipes qui travaillent sérieusement sur le sujet l'assument.
Pourquoi mon chatbot invente-t-il des informations qui sont pourtant dans mes documents ?
Parce que le passage n'était probablement pas dans le contexte passé au modèle au moment de la question : mauvaise recherche, découpage qui a séparé l'information, ou deux versions contradictoires du même document. On commence donc par diagnostiquer la recherche, pas le modèle.
Quelle différence entre un chatbot classique et un chatbot RAG ?
Un chatbot classique répond avec sa mémoire d'entraînement. Un chatbot RAG cherche dans vos documents, puis répond à partir des passages trouvés, avec sources citées, seuils de confiance et mode « je ne sais pas ». Dans les deux cas, il reste indispensable d'évaluer et de surveiller.
Comment détecter une hallucination automatiquement ?
En croisant chaque phrase de la réponse avec le contexte récupéré : validateur de provenance, LLM-as-judge ou métriques de fidélité type RAGAS. La règle de base reste la même : toute réponse doit être sourcée, et toute réponse sans source doit être signalée.
Le fine-tuning réduit-il les hallucinations ?
Moins efficacement que le RAG pour rester fidèle à vos documents. Le fine-tuning apprend un style et un ton, mais ne donne pas au modèle la mémoire de vos versions à jour — et il se met à jour difficilement. Le RAG reste l'approche la plus simple à maintenir.